تم اكتشاف الصفحة ولكن لم تتم فهرستها (Discovered – currently not indexed): الأسباب والحلول
حالة Discovered – currently not indexed (تم اكتشاف الصفحة، ولكن لم تتم فهرستها حتى الآن) في تقرير “فهرسة الصفحات” في Google Search Console تعني أن Google عرفت بوجود رابط الصفحة، من خريطة الموقع أو من رابط يشير إليها، لكنها لم تزحف إليها بعد. السبب الذي تذكره Google رسميًا هو تأجيل الزحف حتى لا يُثقَل الخادم، لكن السبب الأكثر شيوعًا عمليًا هو أن Google لا ترى أولوية كافية لهذه الروابط: محتوى ضعيف، أو روابط داخلية قليلة، أو عدد كبير من الصفحات منخفضة القيمة.
أهم النقاط باختصار
- الصفحة مكتشفة فقط: Google لم تقرأ محتواها بعد، وهذا يختلف عن حالة Crawled – currently not indexed التي قرأت فيها Google الصفحة وقررت عدم فهرستها.
- بحسب Google، يحدث ذلك غالبًا عندما يُتوقَّع أن يُثقل الزحف الموقع، فتُعاد جدولته لوقت لاحق.
- في المواقع الصغيرة يكون السبب عادة إشارات الجودة والأولوية، لا سرعة الخادم.
- الحل الأقوى: تحسين الصفحات المهمة وربطها داخليًا من صفحات مفهرسة، وتقليل الروابط عديمة القيمة التي تستهلك الزحف.
- ليس كل رابط يجب أن يُفهرس، فصفحات الفلترة والوسوم والترقيم وجودها في هذه الحالة أمر طبيعي.
ما معنى Discovered – currently not indexed؟
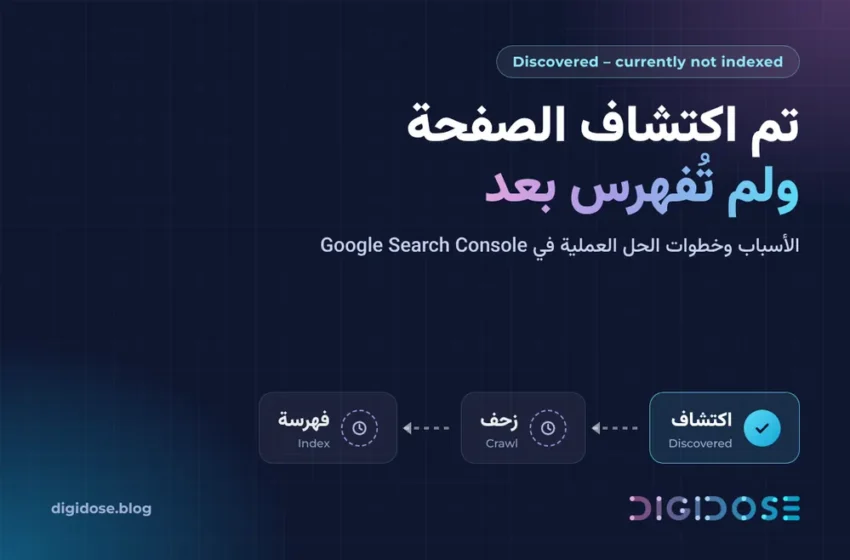
تمر كل صفحة بثلاث مراحل قبل أن تظهر في نتائج البحث: الاكتشاف (Google تعرف أن الرابط موجود)، ثم الزحف (Googlebot يزور الصفحة ويقرأ محتواها)، ثم الفهرسة (إضافة الصفحة إلى فهرس Google). الصفحات في هذه الحالة توقفت عند المرحلة الأولى: الرابط في قائمة انتظار Google، لكن الزحف إليه لم يحدث بعد.
تصف Google هذه الحالة في وثائق Search Console بأنها صفحة عثرت عليها Google ولم تزحف إليها بعد، وتوضح أن ذلك يحدث عادة لأن الزحف كان متوقعًا أن يزيد الحمل على الموقع فأُعيدت جدولته. لذلك ترى في التقرير أن تاريخ آخر زحف للصفحة فارغ.
الفرق بين Discovered وCrawled – currently not indexed
| المقارنة | Discovered – currently not indexed | Crawled – currently not indexed |
|---|---|---|
| هل زارت Google الصفحة؟ | لا، تعرف الرابط فقط | نعم، زحفت إليها وقرأت المحتوى |
| أين توقفت الصفحة؟ | قبل الزحف | بعد الزحف وقبل الفهرسة |
| السبب الأكثر شيوعًا | أولوية زحف منخفضة أو ضغط على الخادم | Google لم ترَ قيمة كافية في المحتوى |
| أين تبدأ الحل؟ | الروابط الداخلية، تقليل الروابط عديمة القيمة، صحة الخادم | جودة المحتوى وتميزه ودمج الصفحات المتشابهة |
إذا كانت صفحاتك في الحالة الثانية، فراجع دليلنا عن حالة Crawled – currently not indexed وخطوات حلها.
لماذا تظهر الصفحات بهذه الحالة؟
1. Google لم تصل إليها بعد
في المواقع الجديدة، أو بعد نشر عدد كبير من الصفحات دفعة واحدة، قد تبقى الروابط في قائمة الانتظار لفترة قبل الزحف إليها. إذا كانت الصفحات حديثة وعددها محدود، فالانتظار مع الربط الداخلي الجيد يكفي في كثير من الحالات.
2. الخادم بطيء أو يعيد أخطاء
عندما يلاحظ Googlebot أن الخادم يستجيب ببطء أو يعيد أخطاء 5xx، يخفّض معدل الزحف حتى لا يضر بالموقع، فتتأخر الروابط الجديدة. هذا هو السبب الذي تذكره وثائق Google، وتأثيره أوضح في المواقع الكبيرة التي تضم آلاف الروابط.
3. إشارات جودة ضعيفة على مستوى الموقع أو القسم
قد تتوقع Google أن صفحات قسم معين أو نمط روابط معين ضعيفة القيمة، بناءً على ما رأته في صفحات مشابهة من الموقع نفسه، فتؤجل الزحف إليها. صفحات المحتوى القصير والمكرر، أو صفحات المنتجات المتشابهة جدًا، مثال شائع على ذلك.
4. روابط داخلية ضعيفة أو صفحات يتيمة
الصفحة التي لا يشير إليها أي رابط من صفحات مهمة في موقعك، ووجدتها Google فقط في خريطة الموقع، تحصل على أولوية زحف منخفضة. الروابط الداخلية من صفحات مفهرسة وذات زيارات هي من أقوى الإشارات على أهمية الصفحة. تعرّف على أفضل ممارسات الروابط الداخلية.
5. روابط كثيرة منخفضة القيمة تستهلك الزحف
روابط الفلترة والترتيب والمعاملات (Parameters)، وأرشيفات الوسوم الكثيرة، وصفحات البحث الداخلي، كلها تولّد آلاف الروابط التي تتنافس على انتباه Googlebot مع صفحاتك المهمة. اقرأ أكثر عن ميزانية الزحف ومتى تحتاج إلى تحسينها.
كيف تشخّص المشكلة في Google Search Console؟
- افتح Search Console، ثم من القائمة اختر الفهرسة ثم الصفحات لفتح تقرير “فهرسة الصفحات”.
- في جدول أسباب عدم فهرسة الصفحات، انقر على Discovered – currently not indexed.
- راجع أمثلة الروابط وصدّر القائمة، ثم صنّفها: صفحات مهمة يجب أن تُفهرس، وصفحات لا تحتاج إلى الفهرسة أصلًا.
- افحص بعض الروابط المهمة بـأداة فحص عنوان URL؛ فالتقرير قد يتأخر، وربما تكون الصفحة قد زُحف إليها أو فُهرست بالفعل.
- افتح الإعدادات ثم إحصاءات الزحف وتحقق من حالة المضيف ومتوسط وقت الاستجابة ونسبة أخطاء الخادم.
إذا كانت معظم الروابط المتأثرة من نمط واحد، مثل روابط فيها معاملات أو أرشيفات وسوم، فالمشكلة غالبًا في بنية الموقع لا في الصفحات نفسها.
كيف تحل Discovered – currently not indexed؟ 6 خطوات عملية
1. حدّد الصفحات التي تستحق الفهرسة فعلًا
لا تحاول فهرسة كل رابط. ركّز على المقالات والخدمات والمنتجات والتصنيفات الرئيسية، واترك صفحات الفلترة والترقيم والبحث الداخلي خارج الحساب.
2. أضف روابط داخلية من صفحات مفهرسة
اربط كل صفحة مهمة متأثرة من صفحتين أو ثلاث صفحات ذات صلة ومفهرسة بالفعل، بنص رابط وصفي، وأضفها إلى صفحات التصنيف أو الصفحات المحورية. هذا يرفع أولوية الزحف أكثر من أي إجراء آخر في المواقع الصغيرة والمتوسطة.
3. حسّن جودة الصفحات وتميزها
ادمج الصفحات المتشابهة في صفحة واحدة أقوى، ووسّع الصفحات القصيرة بمعلومات تجيب فعلًا عن سؤال الباحث، واحذف أو أضف noindex للصفحات التي لا تقدم قيمة. كل ذلك يحسّن الانطباع العام عن موقعك لدى Google.
4. قلّل الروابط التي تهدر الزحف
- امنع الزحف لصفحات البحث الداخلي وروابط المعاملات عديمة القيمة عبر ملف robots.txt.
- تخلص من الروابط الداخلية المكسورة وسلاسل إعادة التوجيه.
- قلّص أرشيفات الوسوم الضعيفة بدمجها أو حذفها مع إعادة توجيه 301.
للتوسع راجع دليل إمكانية الزحف وكيف تحسنها.
5. نظّف خريطة الموقع XML
اجعل خريطة الموقع تضم فقط الروابط القانونية القابلة للفهرسة، بدون صفحات noindex أو روابط تعيد توجيه أو صفحات 404، وتأكد أن تاريخ آخر تعديل (lastmod) يتغير فقط عند تحديث المحتوى فعلًا.
6. حسّن أداء الخادم وسرعة الاستجابة
إذا أظهر تقرير إحصاءات الزحف بطئًا أو أخطاء خادم، فاستخدم التخزين المؤقت وشبكة توصيل المحتوى (CDN)، وراجع الإضافات الثقيلة، وتواصل مع مزوّد الاستضافة إذا استمرت أخطاء 5xx. يمكنك البدء بـأدوات قياس سرعة الموقع.
بعد تطبيق التحسينات، يمكنك طلب الفهرسة لعدد محدود من الصفحات المهمة عبر أداة فحص عنوان URL. هذا الطلب لا يضمن الفهرسة ولا يحل مشكلة على مستوى الموقع، لكنه مفيد للصفحات الأساسية. اقرأ متى وكيف تطلب إعادة فهرسة الموقع بشكل صحيح.
متى لا تحتاج للقلق؟
لا تفهرس Google كل محتوى أي موقع تقريبًا، ووجود بعض الروابط في هذه الحالة طبيعي. لا داعي للقلق إذا كانت الروابط المتأثرة صفحات فلترة أو ترقيم أو أرشيفات أو صفحات قديمة لا تخدم الزائر، أو إذا كانت صفحاتك الأساسية مفهرسة وتظهر في النتائج. القلق يكون مبررًا عندما تبقى صفحات مهمة جديدة في هذه الحالة لأسابيع رغم ربطها داخليًا، أو عندما يرتفع عدد الروابط المتأثرة بسرعة.
الأسئلة الشائعة
ما معنى Discovered – currently not indexed؟
تعني أن Google عرفت رابط الصفحة لكنها لم تزحف إليها ولم تفهرسها بعد، وغالبًا لأنها أجّلت الزحف لتجنب الضغط على الخادم أو لأنها لا ترى أولوية كافية للصفحة.
ما الفرق بينها وبين Crawled – currently not indexed؟
في حالة Discovered لم تزر Google الصفحة أصلًا، بينما في حالة Crawled زارتها وقرأت محتواها ثم قررت عدم فهرستها حاليًا. الأولى تُعالج غالبًا بالروابط الداخلية وبنية الموقع، والثانية بتحسين المحتوى.
هل طلب الفهرسة يحل المشكلة؟
قد يساعد صفحة واحدة مهمة، لكنه لا يحل السبب. إذا كانت مئات الصفحات في هذه الحالة، فالحل في الروابط الداخلية وجودة المحتوى وتقليل الروابط عديمة القيمة.
كم تستغرق الصفحة حتى تُفهرس بعد الإصلاح؟
لا توجد مدة ثابتة؛ قد تُفهرس الصفحة خلال أيام أو تستغرق أسابيع، بحسب حجم الموقع وأولوية الصفحة وصحة الخادم. تابع التقرير وأداة فحص عنوان URL بعد كل تحسين.
هل تضر هذه الحالة بترتيب موقعي؟
لا تعاقب Google الموقع بسببها، لكن الصفحات غير المفهرسة لا يمكن أن تجلب زيارات من البحث. إذا كان العدد كبيرًا جدًا، فهذا مؤشر على مشكلة في بنية الموقع أو جودته تستحق المعالجة.
الخلاصة
حالة Discovered – currently not indexed تعني أن صفحاتك تنتظر الزحف، لا أنها مرفوضة. ابدأ بتحديد الصفحات المهمة، واربطها داخليًا من صفحات قوية، وقلّل الروابط التي تستهلك الزحف بلا فائدة، وتأكد أن الخادم يستجيب بسرعة. للاطلاع على الصورة الكاملة لبنية الموقع، راجع دليل السيو التقني.
المصادر
- تقرير “فهرسة الصفحات” – مساعدة Search Console من Google
- Martin Splitt عن Discovered – currently not indexed – Search Engine Roundtable